Kody kreskowe – przewodnik po symbolikach
Opisy 45 kodów kreskowych i standardów numeracji: od EAN-13 i Code 128, przez kody pocztowe, po QR Code i DataMatrix. Z każdego opisu przejdziesz do strony z budową symbolu i przykładami.Czym jest kod kreskowy
Kod kreskowy zapisuje dane w układzie ciemnych i jasnych elementów, który czytnik zamienia z powrotem na znaki. W kodach liniowych informację niesie szerokość (albo wysokość) kolejnych pasków i odstępów, w kodach 2D – rozmieszczenie modułów na płaszczyźnie.
Sam kod zwykle nie opisuje produktu. Przechowuje numer – GTIN, numer przesyłki, numer seryjny – a nazwa, cena czy stan magazynowy są w bazie danych, w której ten numer jest kluczem. Odczyt skanerem trwa ułamek sekundy i eliminuje błędy przepisywania z klawiatury, dlatego kody kreskowe są podstawą automatycznej identyfikacji (ang. Auto-ID) w handlu, logistyce, produkcji i służbie zdrowia.
Sam kod zwykle nie opisuje produktu. Przechowuje numer – GTIN, numer przesyłki, numer seryjny – a nazwa, cena czy stan magazynowy są w bazie danych, w której ten numer jest kluczem. Odczyt skanerem trwa ułamek sekundy i eliminuje błędy przepisywania z klawiatury, dlatego kody kreskowe są podstawą automatycznej identyfikacji (ang. Auto-ID) w handlu, logistyce, produkcji i służbie zdrowia.
Symbolika, symbol i numer
Symbolika to zbiór reguł danego rodzaju kodu: jakie znaki można zakodować, jak wygląda każdy z nich, jak oznaczyć początek i koniec symbolu, jak szerokie muszą być strefy ciszy i jak liczy się znak kontrolny. Symboliki opisują normy, np. ISO/IEC 15417 dla Code 128 czy ISO/IEC 18004 dla QR Code.
Symbol to konkretny wydrukowany kod – wynik zastosowania reguł symboliki do określonych danych, zwykle z opisem czytelnym dla człowieka pod spodem.
Od symboliki trzeba odróżnić standard numeracji. GTIN, ISBN czy ISSN to numery o określonej budowie, nadawane przez organizacje (GS1, krajowe agencje ISBN i ISSN), a EAN-13 to symbolika, którą się je zapisuje.
Opisanych symbolik są setki, ale w codziennym użyciu jest kilkanaście – wiele starszych kodów wyparły Code 128, GS1-128, DataMatrix i QR Code.
Kody kreskowe liniowe (1D)
W kodzie liniowym dane są zapisane wzdłuż jednej osi, więc symbol odczyta pojedyncza linia skanowania, także tani skaner laserowy. Oznaczenia 2W i 4W w spisie kodów mówią, ile różnych szerokości mają paski i odstępy:
- 2W – dwie szerokości pasków i odstępów: wąska i szeroka (np. Code 39, ITF, Codabar),
- 4W (kody modułowe) – cztery różne szerokości pasków i odstępów, od 1 do 4 modułów (np. Code 128, EAN-13, UPC-A),
- kody pocztowe wysokościowe – paski mają jednakową szerokość, a dane niesie ich wysokość i położenie (np. POSTNET, Royal Mail 4-State).
Kody 1D z dwiema szerokościami elementów (2W)
2 z 5 Industrial
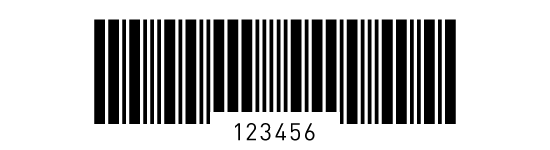
Kod 2 z 5 Industrial zapisuje tylko cyfry. Każdą cyfrę tworzy pięć pasków, z których dwa są szerokie – stąd nazwa. Odstępy między paskami mają stałą szerokość i nie niosą informacji, więc kod jest prosty, ale mało gęsty: przy tej samej liczbie cyfr jest wyraźnie dłuższy niż ITF. Cyfra kontrolna jest opcjonalna. Odmiana 2 z 5 IATA różni się znakami startu i stopu.
2 z 5 Interleaved
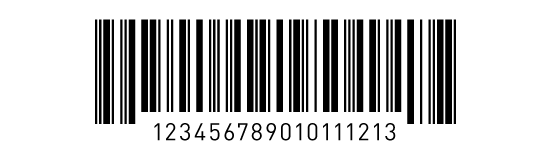
Kod 2 z 5 Interleaved (ITF) koduje cyfry parami: pierwsza cyfra pary jest zapisana w paskach, druga w odstępach między nimi, każda w pięciu elementach, z których dwa są szerokie. Dzięki przeplotowi jest znacznie gęstszy od 2 z 5 Industrial, ale zawsze ma parzystą liczbę cyfr. Najważniejsze zastosowanie to ITF-14: numer GTIN-14 na kartonach zbiorczych, drukowany w ramce z pasków ochronnych (ang. bearer bars), często bezpośrednio na tekturze falistej.
Codabar
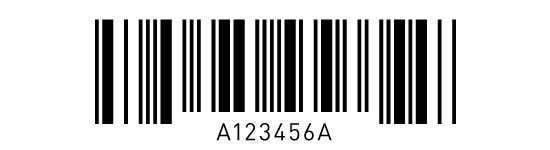
Kod Codabar (znany też jako NW-7) zapisuje cyfry 0–9, sześć znaków - $ : / . + oraz cztery znaki startu i stopu A, B, C, D. Każdy znak ma 7 elementów – 4 paski i 3 odstępy – a znaki są rozdzielone przerwami. Nie ma obowiązkowej cyfry kontrolnej. Do dziś używają go biblioteki; w bankach krwi zastąpił go standard ISBT 128 oparty na Code 128.
Code 39
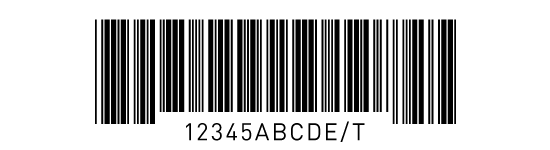
Symbolika Code 39 (kod 3 z 9) zapisuje 43 znaki: cyfry, wielkie litery A–Z, spację i znaki - . $ / + %. Każdy znak ma 9 elementów – 5 pasków i 4 odstępy – z których 3 są szerokie. Początek i koniec symbolu oznacza znak *. Cyfra kontrolna modulo 43 jest opcjonalna, a wariant Full ASCII zapisuje pozostałe znaki ASCII parami znaków. Code 39 przyjął Departament Obrony USA (standard LOGMARS) i branża motoryzacyjna; w nowych wdrożeniach zwykle wybiera się gęstszy Code 128.
Danish PTT 39 Barcode
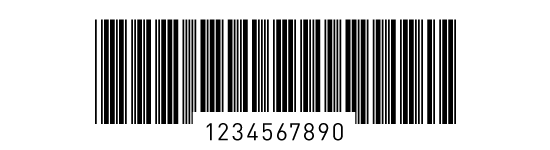
Kod Danish PTT 39 to odmiana Code 39 używana przez pocztę duńską do numerów przesyłek. Budowa znaków, znak startu i stopu są takie same jak w Code 39; odmiana określa format numeru i jego cyfrę kontrolną.
French Postal 39 A/R
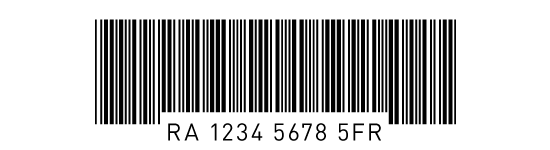
Kod French Postal 39 A/R to Code 39 z numerem przesyłki poleconej za potwierdzeniem odbioru (fr. avis de réception) poczty francuskiej. Numer ma międzynarodowy format UPU S10: dwie litery, osiem cyfr, cyfra kontrolna i kod kraju FR.
German Postal Barcode
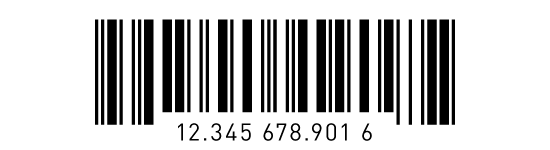
Kod German Postal Barcode poczty niemieckiej występuje w dwóch wariantach: Leitcode z 13 cyframi danych i Identcode z 11 cyframi danych, oba z cyfrą kontrolną na końcu. Oba zapisuje się symboliką ITF (2 z 5 Interleaved). Leitcode koduje adres docelowy (kod pocztowy, ulicę, numer domu) i służy do sortowania, a Identcode identyfikuje pojedynczą przesyłkę.
MSI Plessey
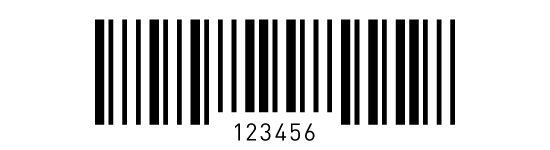
Kod MSI Plessey (MSI) zapisuje wyłącznie cyfry. Każda cyfra to 4 bity, a każdy bit – para pasek i odstęp: szeroki pasek z wąskim odstępem oznacza 1, wąski pasek z szerokim odstępem 0. Cyfrę kontrolną liczy się modulo 10 albo modulo 11, pojedynczo lub podwójnie. Typowe zastosowanie to etykiety półkowe w sklepach i magazynach.
Plessey
Kod Plessey opracowała brytyjska firma Plessey. Zapisuje cyfry 0–9 i litery A–F – każdy znak to 4 bity – a błędy wykrywa 8-bitowa suma kontrolna CRC. Stosowano go w bibliotekach i do etykiet półkowych. Jego uproszczoną odmianą jest MSI Plessey.
Telepen
Kod Telepen zapisuje pełny zestaw 128 znaków ASCII, a w trybie numerycznym koduje cyfry parami, co podwaja gęstość. Opracowała go brytyjska firma SB Electronic Systems; najszerzej przyjął się w bibliotekach w Wielkiej Brytanii.
USPS
Kody USPS to grupa kodów poczty Stanów Zjednoczonych: etykiety worków (8 cyfr) i tac (10 cyfr) z przesyłkami, zapisywane symboliką ITF (2 z 5 Interleaved), oraz znaczniki FIM (ang. Facing Identification Mark). FIM to kilka pionowych kresek w prawym górnym rogu koperty, po których maszyna rozpoznaje rodzaj przesyłki, np. kartę z opłaconą odpowiedzią, i ustawia list stroną adresową.
Code 11
Symbolika Code 11 (USD-8) zapisuje 11 znaków: cyfry 0–9 i myślnik – stąd nazwa. Każdy znak ma 5 elementów (3 paski i 2 odstępy) o dwóch szerokościach. Kod ma słabą odporność na błędy odczytu, dlatego stosuje się jedną cyfrę kontrolną (C) albo dwie (C i K). Używany głównie do oznaczania sprzętu telekomunikacyjnego.
Kody 1D modułowe (4W)
Code 128
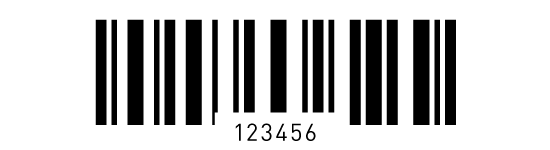
Symbolika Code 128 zapisuje cały zestaw ASCII w trzech zestawach znaków A, B i C, przełączanych wewnątrz symbolu; zestaw C koduje cyfry parami. Każdy znak ma 11 modułów, a obowiązkowy znak kontrolny jest liczony modulo 103. To typowy wybór do etykiet wewnętrznych w magazynie i na produkcji, gdy dane mieszają litery i cyfry.
Code 93
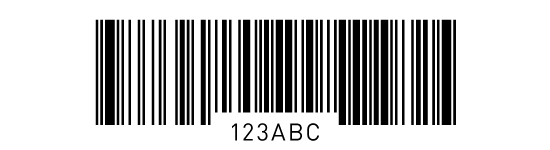
Symbolika Code 93 powstała jako gęstsza i bezpieczniejsza wersja Code 39. Bezpośrednio koduje te same 43 znaki, a cztery dodatkowe znaki przełączające pozwalają zapisać pełny zestaw ASCII. Każdy znak ma 9 modułów (3 paski i 3 odstępy po 1–4 moduły), a symbol zawiera dwa obowiązkowe znaki kontrolne C i K, liczone modulo 47.
GS1-128 (EAN-128)
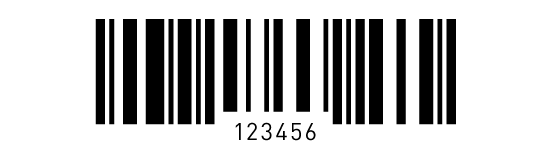
Symbolika GS1-128 (dawniej EAN-128) to Code 128 ze znakiem FNC1 bezpośrednio po znaku startu. Dane zapisuje się w polach poprzedzonych identyfikatorami zastosowania (IZ), np. (00) SSCC palety, (01) GTIN, (10) numer partii, (17) data ważności. To kod etykiety logistycznej GS1; jeden symbol mieści do 48 znaków danych.
EAN-13
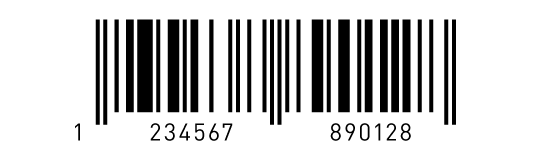
Kod EAN-13 zapisuje 13-cyfrowy numer GTIN-13 i jest podstawowym kodem towarów w handlu detalicznym. Pierwsze cyfry to prefiks GS1, który wskazuje organizację GS1 nadającą numer (590 – GS1 Polska), a nie kraj produkcji. Symbol ma 95 modułów: po 6 cyfr w każdej połowie, a pierwsza cyfra nie ma własnych pasków – wynika z układu zestawów L i G w lewej połowie. Ostatnia cyfra jest kontrolna (modulo 10, wagi 1 i 3).
EAN-8
Kod EAN-8 zapisuje 8-cyfrowy numer GTIN-8 na opakowaniach, na których EAN-13 się nie mieści. Numery GTIN-8 nadaje indywidualnie organizacja GS1 (w Polsce GS1 Polska), zwykle tylko wtedy, gdy na opakowaniu naprawdę brakuje miejsca. Symbol ma 67 modułów i po 4 cyfry w każdej połowie.
ISBN
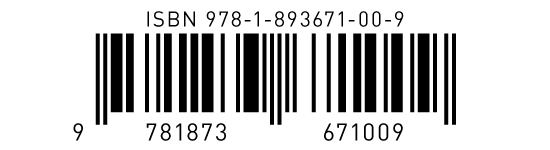
Numer ISBN (International Standard Book Number) identyfikuje konkretne wydanie książki, a na okładce zapisuje się go symbolem EAN-13. Od 2007 roku ISBN ma 13 cyfr: prefiks 978 lub 979, identyfikator grupy (obszaru językowego lub kraju – dla Polski 978-83), identyfikator wydawcy, numer publikacji i cyfrę kontrolną. Każdy format, np. wydanie papierowe i e-book, dostaje osobny numer. W Polsce ISBN nadaje Biblioteka Narodowa.
ISSN
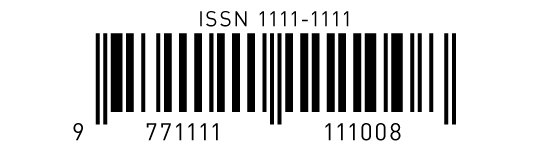
Numer ISSN (International Standard Serial Number) identyfikuje tytuł wydawnictwa ciągłego – gazety, czasopisma, serii. Ma 8 cyfr, z których ostatnia jest kontrolna (modulo 11, może to być X). W kodzie EAN-13 zapisuje się go po prefiksie 977: 7 cyfr ISSN bez cyfry kontrolnej, 2 cyfry kodu wariantu i cyfra kontrolna EAN. Numer wydania można dodać w 2-cyfrowym kodzie dodatkowym. W Polsce ISSN nadaje Biblioteka Narodowa.
Swiss Postal
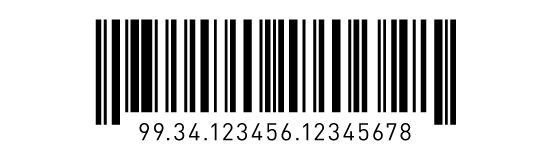
Kod Swiss Postal zapisuje symboliką Code 128 18-cyfrowy numer identyfikacyjny przesyłki poczty szwajcarskiej. Numer składa się z czterech części oddzielanych kropkami w opisie pod kodem; kropki nie są kodowane.
UPC-A
Kod UPC-A zapisuje 12-cyfrowy numer GTIN-12 i jest podstawowym kodem towarów w USA i Kanadzie. Budową odpowiada EAN-13 (95 modułów) – to EAN-13 z zerem na początku numeru – dlatego kasy na całym świecie odczytują oba kody. Numery nadaje GS1 US, a prefiks firmy ma zmienną długość.
UPC-E
Kod UPC-E to skrócona postać UPC-A dla małych opakowań: numer GTIN-12 z odpowiednio rozmieszczonymi zerami zapisuje się sześcioma cyframi. Symbol nie ma środkowego znaku rozdzielającego, a cyfrę systemu liczbowego (0 lub 1) i cyfrę kontrolną koduje układ parzystości tych sześciu cyfr. Czytnik rozwija odczyt z powrotem do 12 cyfr UPC-A.
UPS
Kod UPS to numer przesyłki UPS zapisany symboliką Code 128. Najczęściej spotykany jest format 1Z o 18 znakach: 1Z, 6 znaków numeru nadawcy, 2 cyfry rodzaju usługi, 7 cyfr numeru paczki i cyfrę kontrolną. Na etykietach UPS obok niego drukuje się MaxiCode z danymi do sortowania.
Kody pocztowe z paskami o różnej wysokości
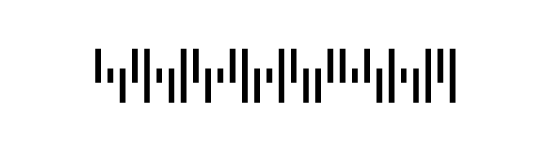
W tych kodach wszystkie paski mają tę samą szerokość i są rozmieszczone w stałych odstępach, a informację niesie wysokość paska i jego położenie względem linii środkowej. Kody dwustanowe (POSTNET) mają paski długie i krótkie. Kody czterostanowe (4-State) mają paski pełne, wydłużone w górę, wydłużone w dół i krótkie środkowe. Odczytują je maszyny sortujące w centrach pocztowych.
POSTNET
Kod POSTNET zapisywał w USA kod pocztowy ZIP (5 cyfr), ZIP+4 (9 cyfr) albo kod punktu doręczenia (11 cyfr), zawsze z cyfrą kontrolną. Każdą cyfrę tworzy 5 pasków, z których dokładnie 2 są długie. Od 2013 roku poczta USA wymaga zamiast niego czterostanowego kodu Intelligent Mail (IMb).
Australia Post 4-State Postal Code
Kod Australia Post 4-State zapisuje identyfikator punktu doręczenia (DPID, 8 cyfr) i opcjonalnie dane klienta. Ma 37, 52 lub 67 pasków, zależnie od formatu, a błędy odczytu koryguje kod Reeda-Solomona.
Dutch 4-State Postal
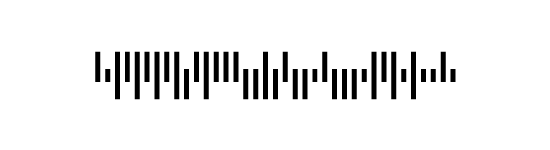
Kod KIX (Klant Index) poczty holenderskiej zapisuje kod pocztowy (4 cyfry i 2 litery), numer domu i ewentualny dodatek do numeru. Używa znaków kodu Royal Mail 4-State, ale bez znaków startu i stopu oraz bez znaku kontrolnego.
Japan Post 4-State Postal Code
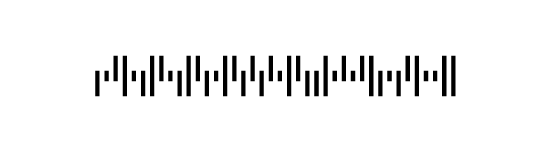
Kod Japan Post 4-State (Customer Barcode) zapisuje 7-cyfrowy kod pocztowy i numer adresu (bloku, budynku), ze znakami startu i stopu oraz znakiem kontrolnym. Poczta japońska używa go do automatycznego sortowania listów do punktu doręczenia.
Royal Mail
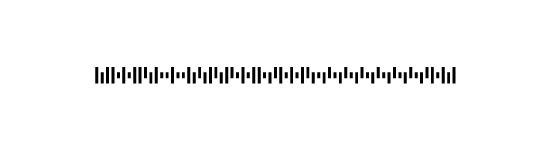
Kod Royal Mail 4-State Customer Code (RM4SCC) zapisuje brytyjski kod pocztowy z dwuznakowym sufiksem punktu doręczenia. Koduje cyfry i wielkie litery; każdy znak to 4 paski, z których 2 sięgają w górę, a 2 w dół. Symbol kończy znak kontrolny. Następcą RM4SCC jest kod Royal Mail Mailmark.
Singapore 4-State Postal Code
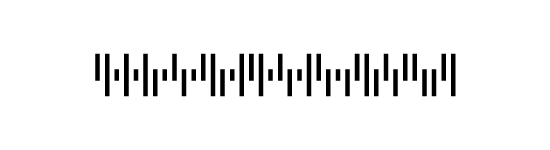
Kod Singapore 4-State Postal Code poczty singapurskiej jest oparty na kodzie Royal Mail 4-State i zapisuje sześciocyfrowy kod pocztowy Singapuru.
Inne kody liniowe i znaczniki
Channel Code
Kod Channel Code jest przeznaczony do bardzo krótkich liczb. Występuje w sześciu wariantach, tzw. kanałach od 3 do 8: im wyższy kanał, tym dłuższy symbol i większy zakres wartości – od 2 cyfr w kanale 3 do 7 cyfr w kanale 8. Przy tak krótkich danych daje mniejszy symbol niż inne kody liniowe.
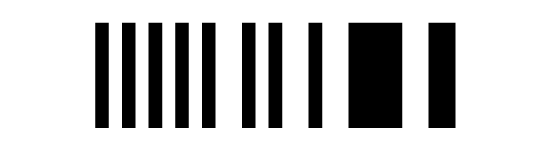
OMR
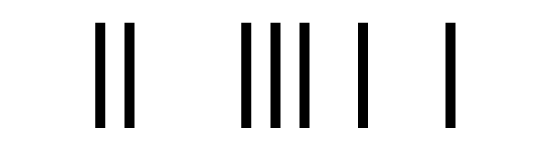
Znaczniki OMR (ang. Optical Mark Recognition) to ciąg kresek drukowanych jedna pod drugą na marginesie kartek korespondencji seryjnej. Czytnik w kopertownicy odczytuje je przy pobieraniu kartki: kreska oznacza bit 1, jej brak – 0. Pierwsza jest kreska START, a ostatnia może być kreska parzystości. Dane sterują m.in. zbieraniem kartek jednego listu i wkładaniem ich do koperty.
Kody dwuwymiarowe (2D) matrycowe
Kody dwuwymiarowe dzielą się na dwie grupy. Kody matrycowe (np. Aztec, DataMatrix, QR Code, MaxiCode) zapisują dane w siatce modułów i mają wzór wyszukiwania, po którym czytnik ustala położenie i orientację symbolu. Kody wielowierszowe (np. PDF417, Code 49, Codablock F) to kilka niskich kodów liniowych ułożonych jeden na drugim.
Większość kodów 2D ma korekcję błędów Reeda-Solomona, więc odczytuje się je mimo częściowego uszkodzenia. Kody matrycowe wymagają czytnika obrazowego (kamery), a część kodów wielowierszowych odczyta też skaner laserowy.
Większość kodów 2D ma korekcję błędów Reeda-Solomona, więc odczytuje się je mimo częściowego uszkodzenia. Kody matrycowe wymagają czytnika obrazowego (kamery), a część kodów wielowierszowych odczyta też skaner laserowy.
Aztec
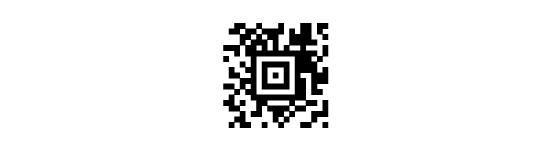
Kod Aztec ma w środku kwadratowy wzór wyszukiwania (tarczę), dzięki czemu nie potrzebuje strefy ciszy wokół symbolu. Stopień korekcji błędów wybiera się od 5 do 95% (zalecane 23%), a największy symbol mieści 3832 cyfry, 3067 znaków alfanumerycznych lub 1914 bajtów. Stosowany na biletach kolejowych i mobilnych kartach pokładowych; w Polsce – na dowodach rejestracyjnych pojazdów.
Code One
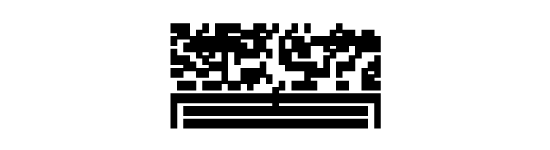
Symbolika Code One, opracowana przez Teda Williamsa, zamiast punktowego wzoru wyszukiwania ma poziome i pionowe linie przechodzące przez środek symbolu. Występuje w wersjach od A do H, różniących się rozmiarem, oraz w niskich wersjach S i T do druku w wąskim pasku.
Data Matrix
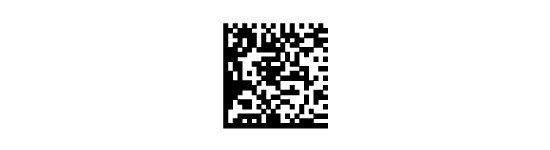
Kod DataMatrix to kwadratowa lub prostokątna matryca z obramowaniem w kształcie litery L z dwóch boków i naprzemiennym wzorem modułów na dwóch pozostałych. Obecna wersja ECC 200 ma korekcję błędów Reeda-Solomona i mieści do 3116 cyfr, 2335 znaków alfanumerycznych lub 1556 bajtów. W wersji GS1 DataMatrix znakuje się nim opakowania leków (numer seryjny), wyroby medyczne (UDI) i części przemysłowe, także bezpośrednio na materiale (DPM): laserem lub udarowo.
Dot Code A
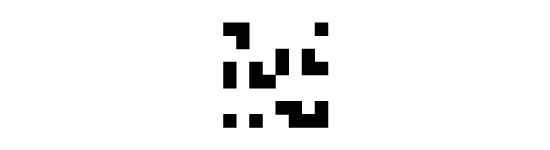
Kod Dot Code A to mała kwadratowa matryca od 6×6 do 12×12 pól, która zapisuje liczbę binarną: od 1 048 576 kombinacji w najmniejszym symbolu do ok. 140 bilionów (1,4 × 10 do potęgi 14) w największym. Pola w narożnikach wyznaczają granice symbolu, a kilka pól przy narożnikach – jego orientację i to, czy obraz nie jest odbiciem lustrzanym. Nie należy go mylić z kodem DotCode (AIM), stosowanym m.in. do znakowania wyrobów tytoniowych w UE.
MaxiCode
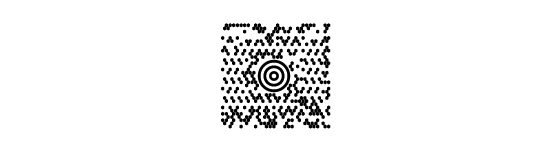
Kod MaxiCode opracowała firma UPS do sortowania paczek. Ma stały rozmiar około 1 cala, w środku wzór z trzech koncentrycznych okręgów, a wokół 884 sześciokątne moduły w 33 rzędach. Mieści do 93 znaków alfanumerycznych lub 138 cyfr. W trybach 2 i 3 pierwszą część symbolu stanowi komunikat przewoźnika – kod pocztowy, kod kraju i klasa usługi – chroniony silniejszą korekcją błędów.
QR Code
Kod QR (QR Code) opracowała w 1994 roku japońska firma Denso Wave. Trzy kwadratowe wzory wyszukiwania w narożnikach pozwalają szybko odczytać go z dowolnego kierunku, także aparatem telefonu. Ma 40 wersji (od 21×21 do 177×177 modułów) i 4 poziomy korekcji błędów L, M, Q, H (ok. 7, 15, 25 i 30%), a największy symbol mieści 7089 cyfr lub 2953 bajty. Służy do linków, płatności, biletów i etykiet, które ma odczytać klient.
Swiss QR Code
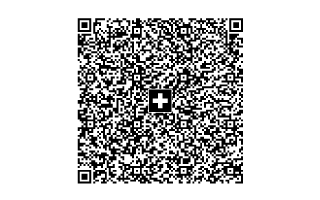
Kod Swiss QR Code to kod QR na szwajcarskim rachunku QR (QR-Rechnung), który od 2022 roku całkowicie zastąpił tradycyjne pomarańczowe i czerwone blankiety wpłat. Ma stały rozmiar 46×46 mm i szwajcarski krzyż w środku, a dane – IBAN lub QR-IBAN odbiorcy, kwotę, walutę i numer referencyjny – zapisuje w ustalonej strukturze. Płacący skanuje kod w aplikacji bankowej, która wypełnia przelew.
Kody dwuwymiarowe (2D) wielowierszowe
Codablock F
Kod Codablock F to Code 128 podzielony na wiersze: od 2 do 44 wierszy po 4–62 znaki, każdy z własnym wskaźnikiem wiersza. Symbol ma dwa znaki kontrolne dla całości danych, a odczyta go zarówno czytnik obrazowy, jak i skaner laserowy przeprowadzany kolejno przez wiersze. Pozwala zmieścić dane Code 128 na wąskiej etykiecie.
Code 16K
Symbolika Code 16K układa od 2 do 16 wierszy, każdy z 5 znaków zestawu Code 128. Mieści do 77 znaków ASCII lub 154 cyfry. Wiersze są rozpoznawalne po kombinacji znaków startu i stopu, więc czytnik może je odczytać w dowolnej kolejności.
Code 49
Symbolika Code 49 opracowana w 1987 roku przez Davida Allaisa z firmy Intermec ma od 2 do 8 wierszy; każdy wiersz zawiera 4 słowa kodowe (8 znaków) i własny znak kontrolny. Bezpośrednio koduje 49 znaków – stąd nazwa – a pozostałe znaki ASCII przez znaki przełączające. Mieści do 49 znaków alfanumerycznych lub 81 cyfr.
PDF417
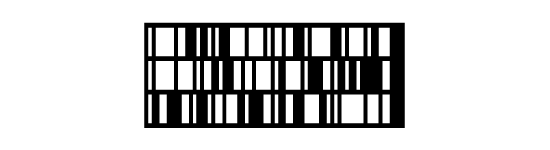
Kod PDF417 (Portable Data File) ma od 3 do 90 wierszy i od 1 do 30 kolumn danych. Każde słowo kodowe składa się z 4 pasków i 4 odstępów o łącznej szerokości 17 modułów – stąd „417”. Ma 9 poziomów korekcji błędów Reeda-Solomona (0–8) i mieści do 1850 znaków tekstu, 2710 cyfr lub 1108 bajtów. Stosowany m.in. na amerykańskich prawach jazdy, papierowych kartach pokładowych i dokumentach przewozowych.
SuperCode
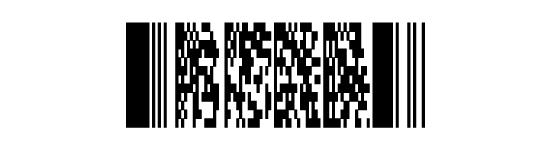
Kod SuperCode zaproponował twórca PDF417, Ynjiun P. Wang. Dane są podzielone na pakiety, które można układać elastycznie, dopasowując kształt symbolu do miejsca na etykiecie. Symbolika nie przyjęła się szeroko.
Kody złożone i GS1 DataBar
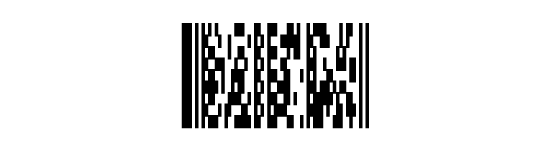
Kod złożony łączy kod liniowy z dwuwymiarowym. Część liniowa zawiera podstawowy identyfikator (np. GTIN) i odczyta ją każdy skaner, a dodatkowe dane, np. numer partii czy data ważności, są w części 2D nad nią. W systemie GS1 taką rolę pełni GS1 Composite, w którym częścią liniową jest najczęściej GS1 DataBar.
Aztec Mesas
Kod Aztec Mesas dodaje do zwykłego kodu liniowego warstwy danych zapisanych na wzór kodu Aztec. Częścią liniową może być Code 128, Code 39, Code 93, ITF, UPC-A lub EAN-13, a warstwy umieszcza się nad nią albo nad i pod nią. Skaner liniowy odczyta sam kod kreskowy, czytnik obrazowy – całość. Stopień korekcji błędów wybiera się od 5 do 95%.
GS1 DataBar (RSS)
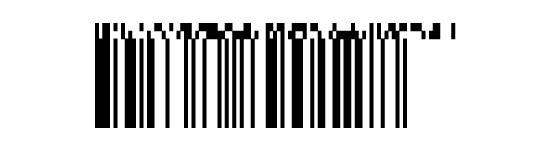
Symbolika GS1 DataBar (dawniej RSS) to rodzina siedmiu kodów liniowych GS1. Odmiany Omnidirectional, Truncated, Stacked, Stacked Omnidirectional i Limited kodują sam GTIN-14 na mniejszej powierzchni niż EAN-13, np. na owocach i drobnych artykułach. Expanded i Expanded Stacked zapisują dodatkowo dane w IZ, np. masę, cenę i datę ważności (do 74 cyfr lub 41 liter). DataBar bywa częścią liniową kodu złożonego GS1 Composite, ale sam jest kodem liniowym.
Historia kodów kreskowych
W 1932 roku Wallace Flint, student Harvard Business School, opisał system, w którym klient wybiera towar z katalogu, wyjmując odpowiednią kartę perforowaną. Kontroler wkładał kartę do czytnika, system dostarczał produkt z magazynu do kasy, drukował rachunek i aktualizował stan magazynu.
Era nowoczesnych kodów kreskowych zaczęła się w 1948 roku. Bernard Silver, doktorant Politechniki Drexel w Filadelfii, podjął temat automatycznego odczytu informacji o produktach razem z Normanem Woodlandem, wówczas 27-letnim doktorantem i wykładowcą tej uczelni. Pierwszy pomysł – tusz świecący w ultrafiolecie – działał, ale tusz był niestabilny, a druk drogi. Woodland przerwał pracę na uczelni i przeniósł się na Florydę, żeby zająć się problemem. 20 października 1949 roku obaj złożyli wniosek patentowy „Classifying Apparatus and Method” (urządzenie i metoda klasyfikacji), opisując wynalazek jako sztukę klasyfikowania przedmiotów przez rozpoznawanie wzorów.
Era nowoczesnych kodów kreskowych zaczęła się w 1948 roku. Bernard Silver, doktorant Politechniki Drexel w Filadelfii, podjął temat automatycznego odczytu informacji o produktach razem z Normanem Woodlandem, wówczas 27-letnim doktorantem i wykładowcą tej uczelni. Pierwszy pomysł – tusz świecący w ultrafiolecie – działał, ale tusz był niestabilny, a druk drogi. Woodland przerwał pracę na uczelni i przeniósł się na Florydę, żeby zająć się problemem. 20 października 1949 roku obaj złożyli wniosek patentowy „Classifying Apparatus and Method” (urządzenie i metoda klasyfikacji), opisując wynalazek jako sztukę klasyfikowania przedmiotów przez rozpoznawanie wzorów.
Pierwszy kod: tarcza strzelnicza
Ze względu na wygląd pierwszy kod kreskowy nazwano tarczą strzelniczą (ang. bull's eye) – składał się z koncentrycznych okręgów. Wniosek patentowy opisywał jednak również wersję z prostymi liniami, podobną do dzisiejszych kodów liniowych: 4 białe kreski na ciemnym tle. Pierwsza kreska była punktem odniesienia, a informację niosła obecność lub brak pozostałych trzech, co pozwalało rozróżnić 7 towarów. Wynalazcy zauważyli, że 10 kresek daje już 1023 kombinacje.
Silver zmarł w wieku 38 lat, nie doczekawszy komercyjnego zastosowania kodów kreskowych. W 1992 roku prezydent George H. W. Bush przyznał Woodlandowi National Medal of Technology. Żaden z wynalazców nie zarobił na pomyśle, który zapoczątkował ogromny rynek.
Silver zmarł w wieku 38 lat, nie doczekawszy komercyjnego zastosowania kodów kreskowych. W 1992 roku prezydent George H. W. Bush przyznał Woodlandowi National Medal of Technology. Żaden z wynalazców nie zarobił na pomyśle, który zapoczątkował ogromny rynek.
Od testów w sklepie do kodu UPC
W 1966 roku amerykańskie stowarzyszenie sieci spożywczych NAFC (National Association of Food Chains) zwróciło się do producentów sprzętu o system przyspieszający obsługę przy kasie. Firma RCA uruchomiła testowy system skanujący w sklepie sieci Kroger w Cincinnati, z kodami w kształcie tarczy strzelniczej. Naklejali je pracownicy sklepu, a nie producenci. Szybko okazało się, że branża potrzebuje jednego, otwartego standardu, który przyjmą wszyscy producenci żywności i dystrybutorzy.
W 1969 roku NAFC zleciła opracowanie takiego standardu firmie Logicon, która latem 1970 roku przedstawiła UGPIC (Universal Grocery Products Identification Code). Na tej podstawie powołano komitet ds. kodu Uniform Grocery Product Code, który w 1973 roku wybrał propozycję IBM, rozwijaną przez George'a Laurera na bazie pomysłów Woodlanda i Silvera. Tak powstał kod UPC, używany w USA do dziś.
W 1969 roku NAFC zleciła opracowanie takiego standardu firmie Logicon, która latem 1970 roku przedstawiła UGPIC (Universal Grocery Products Identification Code). Na tej podstawie powołano komitet ds. kodu Uniform Grocery Product Code, który w 1973 roku wybrał propozycję IBM, rozwijaną przez George'a Laurera na bazie pomysłów Woodlanda i Silvera. Tak powstał kod UPC, używany w USA do dziś.
Pierwsze skanowanie i zastosowania w przemyśle
26 czerwca 1974 roku w supermarkecie Marsh w Troy (Ohio) skaner NCR po raz pierwszy odczytał kod UPC na produkcie. Była to paczka dziesięciu gum do żucia Wrigley's – nie wybrano jej specjalnie, po prostu kasjer zeskanował ją jako pierwszą. Paczka jest dziś eksponatem Narodowego Muzeum Historii Amerykańskiej w Waszyngtonie (Smithsonian Institution).
Wcześniej, w latach 50., próby automatycznej identyfikacji podjęło stowarzyszenie kolei amerykańskich AAR. W 1967 roku przyjęło ono optyczny kod do oznaczania wagonów; znakowanie i instalacja czytników zaczęły się 10 października 1967 roku. Po siedmiu latach oznaczono 95% taboru, ale system się nie sprawdził i w latach 70. go porzucono. Za początek przemysłowego zastosowania kodów kreskowych uznaje się rok 1981, kiedy Departament Obrony USA wprowadził Code 39 do oznaczania wszystkich produktów dostarczanych armii (standard LOGMARS).
Wcześniej, w latach 50., próby automatycznej identyfikacji podjęło stowarzyszenie kolei amerykańskich AAR. W 1967 roku przyjęło ono optyczny kod do oznaczania wagonów; znakowanie i instalacja czytników zaczęły się 10 października 1967 roku. Po siedmiu latach oznaczono 95% taboru, ale system się nie sprawdził i w latach 70. go porzucono. Za początek przemysłowego zastosowania kodów kreskowych uznaje się rok 1981, kiedy Departament Obrony USA wprowadził Code 39 do oznaczania wszystkich produktów dostarczanych armii (standard LOGMARS).
Jakie są rodzaje kodów kreskowych?
Podstawowy podział to kody liniowe (1D) i dwuwymiarowe (2D). Kody liniowe dzielą się na kody 2W (dwie szerokości elementów, np. Code 39, ITF), kody modułowe 4W (np. Code 128, EAN-13) i pocztowe kody wysokościowe (np. POSTNET, Royal Mail 4-State). Kody 2D to kody matrycowe (np. QR Code, DataMatrix, Aztec) i wielowierszowe (np. PDF417). Osobną grupą są kody złożone, łączące część liniową z dwuwymiarową.
Czy kod kreskowy wskazuje kraj produkcji towaru?
Nie. Pierwsze cyfry kodu EAN-13 to prefiks GS1, który wskazuje organizację GS1 nadającą numer. Prefiks 590 oznacza, że numer nadała GS1 Polska, czyli właściciel marki jest jej członkiem. Towar mógł zostać wyprodukowany w dowolnym kraju.
Jak uzyskać kod kreskowy EAN dla swojego produktu?
Numery GTIN do towarów sprzedawanych w sklepach nadaje organizacja GS1 – w Polsce GS1 Polska. Firma otrzymuje prefiks firmy GS1 i z niego tworzy numery dla swoich produktów, a symbol EAN-13 można potem wygenerować samodzielnie. Do użytku wyłącznie wewnątrz firmy GS1 przewiduje numery z prefiksem 20–29, które nie trafiają do obrotu zewnętrznego. Numerów wymyślonych samodzielnie nie należy umieszczać na towarach w sprzedaży.
Czym różni się kod 1D od kodu 2D?
Kod 1D zapisuje dane wzdłuż jednej osi i zwykle mieści kilkanaście–kilkadziesiąt znaków, najczęściej sam numer. Kod 2D zapisuje dane na płaszczyźnie, mieści setki lub tysiące znaków, ma korekcję błędów i daje się odczytać mimo częściowego uszkodzenia. Kody liniowe odczyta skaner laserowy; kody matrycowe 2D wymagają czytnika obrazowego.
Czy telefon odczyta każdy kod kreskowy?
Aparat w większości smartfonów rozpoznaje kody QR bez dodatkowych aplikacji. Do pozostałych symbolik – EAN-13, Code 128, DataMatrix – potrzebna jest aplikacja ze skanerem kodów. Małe kody liniowe z wąskimi modułami bywają dla aparatu telefonu trudne do odczytu; w pracy ciągłej (magazyn, kasa) lepiej sprawdza się dedykowany czytnik.
Jaki kod kreskowy wybrać do oznaczania w firmie?
Zależy od danych i od tego, kto będzie kod czytał:
- towary w sprzedaży detalicznej – EAN-13 z numerem GTIN od GS1,
- etykiety logistyczne dla partnerów handlowych – GS1-128 z numerem SSCC,
- etykiety wewnętrzne (lokalizacje, numery seryjne, partie) – Code 128,
- małe elementy i znakowanie bezpośrednie na części – DataMatrix,
- kod do odczytu przez klienta telefonem – QR Code.
Aktualizacja: 11.2026 · Opracowanie: dział techniczny HDF Software